 الذكاء الاصطناعي
سامسونج تطلق The Brief للأجهزة المنزلية الذكية عالمياً
الموجزأنهت شركة سامسونج للإلكترونيات سلسلة ندواتها التقنية العالمية The Brief لاستعراض جيل جديد من الأجهزة المنزلية المدعومة بالذكاء الاصطناعي.شملت الفعاليات...
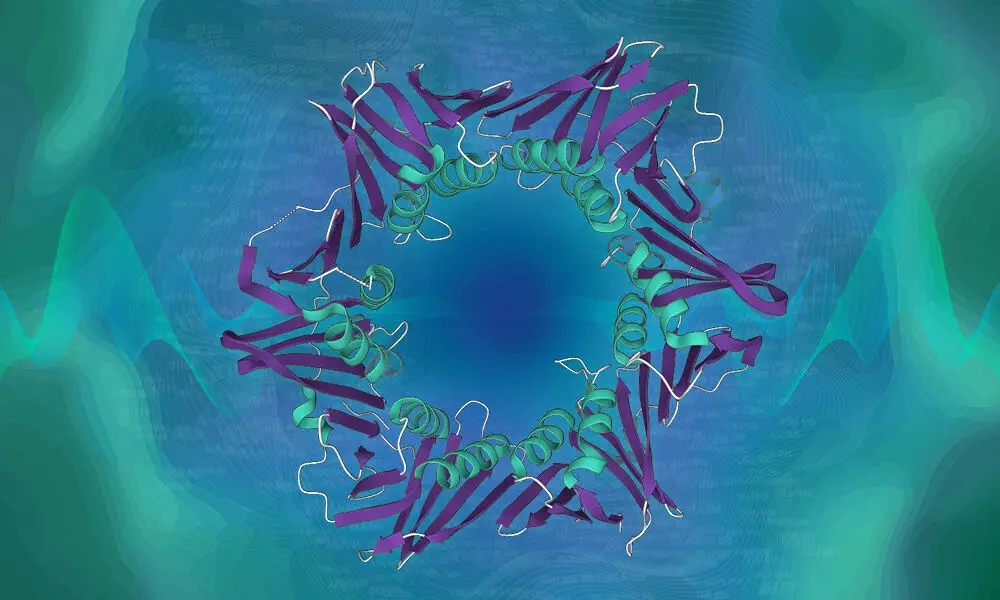
أطلقت جوجل نموذجاً جديداً للتعلم العميق يُدعى "ProtNLM" (Protein Natural Language Model)، بهدف تسريع اكتشاف الببتيدات المضادة للميكروبات وفك شفرات البروتينات المجهولة. تسعى هذه الخطوة التقنية إلى مواجهة أزمة مقاومة المضادات الحيوية العالمية، من خلال تحليل ملايين التسلسلات الحيوية التي كانت تفتقر إلى توصيف وظيفي في قواعد البيانات العلمية.
تمثل مقاومة الميكروبات للمضادات الحيوية التقليدية واحداً من أخطر التحديات الصحية في العصر الحديث، حيث تشير التقديرات العلمية إلى أنها قد تتسبب في وفاة نحو 10 ملايين شخص سنوياً بحلول عام 2050 إذا لم يتم تطوير بدائل علاجية فعالة. في هذا الصدد، تبرز الببتيدات المضادة للميكروبات (AMPs)، وتحديداً "البكتيريوسينات"، كحل واعد للغاية؛ فهي جزيئات تطورت طبيعياً لاستهداف نقاط ضعف جوهرية في البكتيريا المنافسة، مما يجعل من الصعب جداً على مسببات الأمراض تطوير آليات دفاعية أو مقاومة ضدها مقارنة بالمضادات الحيوية الكيميائية التقليدية.
وعلى الرغم من أن الطبيعة غنية بهذه الببتيدات، إلا أن عملية اكتشافها ظلت بطيئة ومعقدة. وقد نجحت عمليات التنقيب الجينومي السابقة في تحديد ببتيدات هامة تُستخدم عالمياً مثل "النيسين" (Nisin)، واكتشافات حديثة أخرى مثل "الداروباكتين" (Darobactin) و"اللاريوسيدين" (Lariocidin)، لكن هذه تظل مجرد قطرة في غيث من البيانات الحيوية الهائلة التي لم تُكتشف أسرارها بعد.
تكمن المشكلة الأساسية في أن قواعد البيانات العالمية، مثل "UniProt" التي تُعد المرجع الأول لبيانات البروتينات، تعج بمليارات تسلسلات الأحماض الأمينية التي لا تُعرف وظيفتها الحقيقية. يُطلق العلماء على هذه البيانات اسم "المادة المظلمة" للبروتينات؛ وهي تسلسلات ناتجة عن مشاريع تسلسل الجينوم لكنها لا تشبه أي بروتينات معروفة سابقاً، مما يجعل تصنيفها أو فهم دورها البيولوجي مستحيلاً باستخدام الطرق التقليدية التي تعتمد على المقارنة والتشابه.
هنا يأتي دور التكنولوجيا التي طورتها جوجل لسد هذه الفجوة المعرفية. فبدلاً من محاولة مطابقة البروتينات المجهولة بنماذج قديمة، يتعامل نموذج "ProtNLM" مع الأحماض الأمينية كأنها "لغة" لها قواعدها الخاصة. تم تدريب هذا النموذج ليكون قادراً على قراءة "القواعد التطورية" الكامنة في تسلسلات الأحماض الأمينية وفهم سياقها، تماماً كما تفهم نماذج اللغة الكبيرة سياق الكلمات في الجملة، مما يسمح له بالتنبؤ بالوظيفة البيولوجية للبروتين مباشرة من تسلسله الخام دون الحاجة لبيانات مرجعية سابقة.
يمثل نموذج "ProtNLM" تحولاً من البحث اليدوي والمحدود إلى التوصيف الآلي واسع النطاق، حيث نجح بالفعل في إثراء ملايين الإدخالات في قاعدة بيانات "UniProt" بتسميات وظيفية عالية الدقة. هذا التطور يعني أن الباحثين في المختبرات لم يعودوا بحاجة للبدء من الصفر أو تخمين وظائف البروتينات، بل أصبح لديهم خريطة واضحة تحدد لهم المرشحين الأكثر قوة ليكونوا مضادات حيوية مستقبلية.
وتتجلى أهمية هذه التقنية في قدرتها على استخلاص المعلومات من البيانات غير المصنفة، وهو ما يسرع وتيرة العمل في التكنولوجيا الحيوية بشكل غير مسبوق. فبينما كانت الاكتشافات السابقة تستغرق سنوات من البحث والتجارب لتحديد وظيفة بروتين واحد، يمكن للنموذج الجديد معالجة ملايين التسلسلات في وقت قياسي، مما يضع بين أيدي العلماء قائمة قصيرة ومركزة من الببتيدات التي تمتلك أعلى احتمالية للنجاح كعلاجات فعالة.
إن توفر هذه البيانات المصنفة والمدعومة بالذكاء الاصطناعي متاح الآن للعلماء والباحثين حول العالم عبر منصة "UniProt" العالمية، وهي خطوة تضع أدوات متقدمة في متناول المؤسسات البحثية، بما في ذلك تلك الموجودة في المنطقة العربية التي تعتمد على هذه القواعد البياناتية في أبحاثها الدوائية والجينية. الخطوة القادمة للمجتمع العلمي هي البدء في اختبار هذه البروتينات المكتشفة حديثاً مخبرياً، لتحويل هذه التوقعات الرقمية إلى حلول طبية تنقذ ملايين الأرواح. للمهتمين بمجال الأبحاث الحيوية، يمثل الاعتماد على هذه التصنيفات الجديدة في "UniProt" نقطة انطلاق جوهرية لتسريع مشاريع تطوير الأدوية.
المصدر: Google DeepMind
 الذكاء الاصطناعي
الموجزأنهت شركة سامسونج للإلكترونيات سلسلة ندواتها التقنية العالمية The Brief لاستعراض جيل جديد من الأجهزة المنزلية المدعومة بالذكاء الاصطناعي.شملت الفعاليات...
 الذكاء الاصطناعي
الموجزنجح باحثون من شركة إنفيديا في إجراء أضخم محاكاة كمومية مقاومة للأخطاء تشمل 104 كيوبت باستخدام حاسوب جوبيتر الفائق في...
 أجهزة اللابتوب
الموجزأعلنت إنفيديا عالمياً عن إطلاق أجهزة الحاسوب المحمولة الجديدة RTX Spark المخصصة للذكاء الاصطناعي وإنشاء المحتوى والألعاب بالتعاون مع كبرى...