 نماذج الذكاء الاصطناعي
Gemini Notebook يتيح تحكماً إبداعياً في العروض والفيديو
الموجزأطلقت جوجل تحديثاً لمنصة Gemini Notebook يمنح المستخدمين تحكماً إبداعياً أوسع ومسار عمل تفاعلي لإنشاء العروض التقديمية وملخصات الفيديو.يتضمن التحديث...
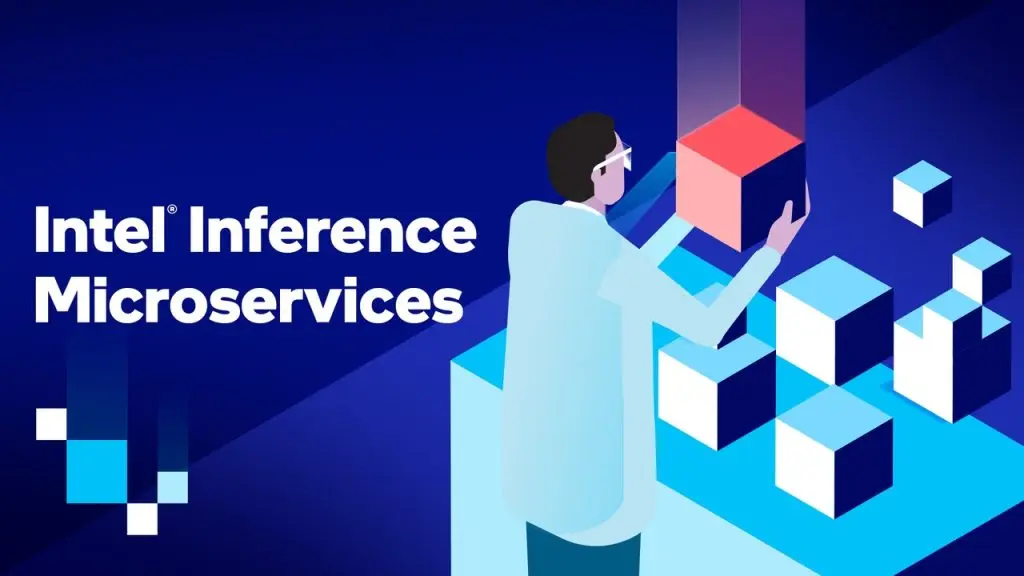
أطلقت شركة إنتل (Intel) رسمياً "خدمات إنتل للاستدلال المصغرة" (Intel Inference Microservices)، وهي تقنية جديدة تهدف إلى تبسيط تشغيل نماذج اللغات الكبيرة (LLMs) على معالجاتها الحالية. تتيح هذه الخدمة للمطورين والشركات تشغيل الذكاء الاصطناعي بكفاءة عالية دون الحاجة إلى خبرة عميقة في تحسين الأداء أو شراء عتاد جديد، وذلك من خلال حاويات برمجية (Containers) تهيئ نفسها تلقائياً بناءً على نوع المعالج المستخدم.
تكمن المشكلة الكبرى التي يواجهها المطورون عند تشغيل نماذج الذكاء الاصطناعي في أن الحصول على استجابة من النموذج أمر سهل، لكن الحصول على أداء مستقر وسريع يتطلب عادةً أسبوعاً من العمل التقني المضني. يتضمن ذلك ضبط توزيع العمل على أنوية المعالج، وتنظيم الذاكرة، واختيار مجموعات التعليمات البرمجية المناسبة. وبمجرد تغيير النموذج أو جيل المعالج، تضيع كل هذه الإعدادات ويصبح من الضروري البدء من الصفر.
تعالج "خدمات إنتل المصغرة" هذه المعضلة عبر حاويات برمجية ذكية؛ فبمجرد تشغيل الحاوية، تقوم بفحص المعالج الذي تعمل عليه (سواء كان من الجيل الرابع أو الخامس أو السادس من معالجات Xeon)، ثم تختار تلقائياً أفضل ملف تعريف (Profile) تم ضبطه واختباره مسبقاً من قبل مهندسي إنتل لهذا النموذج تحديداً. هذا يعني أن المطور يختار النموذج فقط، بينما تتولى الحاوية اختيار الإعدادات المثالية لضمان أعلى سرعة ممكنة.
بدلاً من اختراع بروتوكولات جديدة تزيد من تعقيد العمل، اعتمدت إنتل واجهة برمجة تطبيقات (API) متوافقة تماماً مع معايير OpenAI. هذه الخطوة تعني أن أغلب أدوات الذكاء الاصطناعي الحالية مثل LangChain وLlamaIndex وLiteLLM ستعمل مباشرة مع تقنية إنتل دون الحاجة لتعديل الكود البرمجي، بل يقتصر الأمر على تغيير رابط الوصل (URL) فقط.
تعمل هذه الخدمات في إصدارها الأول على معالجات Intel Xeon، وتستخدم محرك vLLM للاستدلال. كما تدعم نماذج شهيرة مثل Qwen3-4B، حيث يمكن للمستخدم سحب صورة الحاوية وتشغيلها بأمر واحد فقط. بمجرد التشغيل، تكتشف الحاوية وجود مسرعات مدمجة في السيليكون مثل "إضافات المصفوفات المتقدمة" (Intel AMX) وتفعلها تلقائياً، وهي تقنيات موجودة بالفعل في المعالجات الحديثة لكنها غالباً ما تظل غير مستغلة بسبب صعوبة ضبطها يدوياً.
بالنسبة لقطاع الأعمال، يغير هذا الإعلان قواعد اللعبة من الناحية الاقتصادية والزمنية؛ فبدلاً من انتظار دورات المشتريات الطويلة لتوفير بطاقات رسومية (GPUs) باهظة الثمن، يمكن للشركات البدء فوراً باستخدام سعة معالجات Xeon التي تمتلكها بالفعل في مراكز بياناتها. هذا يحول قرار تشغيل الذكاء الاصطناعي من "شراء أصول جديدة" إلى مجرد "قرار جدولة" على الموارد المتاحة.
علاوة على ذلك، توفر هذه الطريقة أماناً عالياً للبيانات، حيث تعمل النماذج بالكامل داخل بيئة الشركة وعلى عتادها الخاص، دون الحاجة لإرسال البيانات إلى خوادم سحابية خارجية أو الاعتماد على مفاتيح API من مزودين آخرين. كما تضمن إنتل أن ما يتم بناؤه اليوم على معالجات Xeon سيكون قابلاً للانتقال مستقبلاً إلى معالجات الرسوميات الخاصة بها (مثل GPUs Crescent Island) دون إعادة كتابة التطبيقات، حيث تظل واجهة البرمجة ثابتة بينما يتغير العتاد في الخلفية فقط.
تتوفر "خدمات إنتل للاستدلال المصغرة" حالياً كبرمجيات يتم تشغيلها على البنية التحتية الخاصة بالمستخدم، وهي تدعم بيئات Docker وKubernetes (الإصدار 1.24 فأحدث). يمكن للمطورين العثور على النماذج المدعومة وتراخيصها عبر دليل برمجيات إنتل (Intel Software Catalog).
تعتزم إنتل في الإصدارات القادمة التوسع لدعم نطاق أعرض من المعالجات والمحركات، مع إضافة أدوات إضافية مثل Helm charts لتسهيل النشر على نطاق واسع. الخطوة التالية للمؤسسات التي تمتلك معالجات Intel Xeon من الأجيال الحديثة هي البدء بتجربة سحب الصور البرمجية (Images) واختبار الأداء مباشرة، حيث يتوقع أن يكون هذا المسار هو المعيار الموحد للاستدلال عبر كافة منصات إنتل المستقبلية.
المصدر: Intel
 نماذج الذكاء الاصطناعي
الموجزأطلقت جوجل تحديثاً لمنصة Gemini Notebook يمنح المستخدمين تحكماً إبداعياً أوسع ومسار عمل تفاعلي لإنشاء العروض التقديمية وملخصات الفيديو.يتضمن التحديث...
 نماذج الذكاء الاصطناعي
الموجزأطلقت جوجل تحديثات جديدة لمنصة Gemini Notebook لتحويل تجربة المذاكرة التقليدية إلى عملية تفاعلية مدعومة بالذكاء الاصطناعي.تتضمن التحديثات ميزة توليد...
 نماذج الذكاء الاصطناعي
الموجزأطلقت شركة أنثروبيك مرحلة جديدة من الشفافية التقنية عبر منح فريق من منظمة METR صلاحيات وصول شاملة لتقييم مخاطر النماذج.حصل...